İSTANBUL (KFK Ajans) - Yapay zekâ sistemlerinin dilleri anlama ve işleme sürecinde uygulanan parçalama yöntemleri, Türkçe kullanıcıları için ek maliyet ve işlem yükü oluşturuyor. Türkiye Today tarafından aktarılan habere göre, metinleri "token" adı verilen parçalara bölerek işleyen yapay zekâ modelleri, Türkçe ifadeleri İngilizceye kıyasla belirgin şekilde daha fazla parçaya ayırıyor.
- OpenAI, Google, Meta, Alibaba ve DeepSeek modellerinde Türkçe metinlerin İngilizceye göre yüzde 31 ila yüzde 83 daha fazla token tükettiği belirlendi.
- Dört üniversiteden araştırmacıların yürüttüğü çalışmada, dört büyük yapay zekâ modeli 6 bin 200 Türkçe sınav sorusuyla test edildi.
- Dil Yapay Zekâsı Eşitliği Koalisyonu verilerine göre en maliyetli diller en ucuz olanlara kıyasla 1,5 ila 5 kat daha fazla token harcıyor.
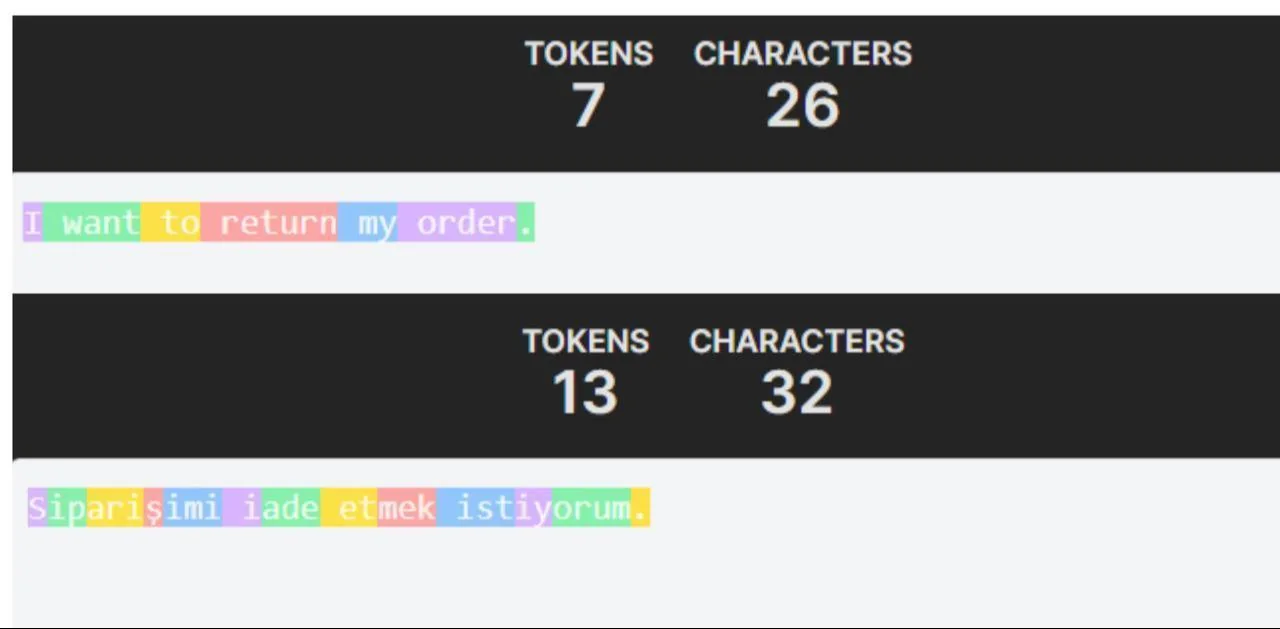
Yapılan testlerde, İngilizce 13 parçaya bölünen bir cümlenin Türkçe karşılığı olan iki kelimelik ifade 15 parçaya kadar ayrıldı. OpenAI, Google, Meta, Alibaba ve DeepSeek tarafından geliştirilen beş farklı model üzerinde gerçekleştirilen denemelerde, Türkçenin İngilizceye göre yüzde 31 ila yüzde 83 arasında daha fazla token gerektirdiği saptandı.
Token Sayımı ve Dil Yapısının Etkisi
Yapay zekâ sistemlerinde token sayıları maliyeti, yanıt hızını ve modelin hafızasında tutabileceği metin miktarını doğrudan belirliyor. Dil Yapay Zekâsı Eşitliği Koalisyonu (CLEAR) tarafından hazırlanan ve Rest of World tarafından aktarılan analize göre, internetteki en popüler 20 dil arasında en pahalı diller en ucuz olanlara göre 1,5 ila 5 kat daha fazla token tüketiyor.
Türkçenin sondan eklemeli yapısı nedeniyle köklere ekler getirilerek tek bir sözcükle geniş anlamlar kurulabiliyor. Ağırlıklı olarak İngilizce verilerle eğitilen modeller bu ekleri tanımakta zorlanarak kelimeleri çok sayıda küçük parçaya ayırıyor ve bu durum DeepSeek modelinde yüzde 83'lük bir farka kadar ulaşıyor.
Akademik Araştırmalar ve Sektörel Yansımalar
Üçü İstanbul'da bulunan dört üniversiteden araştırmacılar, dört büyük modeli 6 bin 200 Türkçe sınav sorusu üzerinde sınadı. Araştırma sonucunda, modellerin başarısının yalnızca model boyutuna bağlı kalmadığı, parçaların gerçek Türkçe sözcüklerle örtüştüğü durumlarda performansın belirgin şekilde arttığı kaydedildi.
Türkiye Today Teknoloji Direktörü Uğur Sergin, kendi içerik yönetim sistemlerini test ederken Türkçenin sondan eklemeli yapısı nedeniyle token sınırlarına daha hızlı ulaşıldığını belirtti. Sergin, bu durumun uygulama programlama arayüzü (API) üzerinden çalışırken Türkçe kullanımını daha maliyetli hâle getirdiğini ve teknik terimleri modellerin daha iyi işlemesi için İngilizce bırakmak durumunda kaldıklarını ifade etti.
Maya Research Üst Yöneticisi Dheemanth Reddy, fiyat indirimlerinin fayda sağlayacağını ancak farkın kapanması için laboratuvarların bu dillere özel parçalayıcılar tasarlaması gerektiğini vurguladı. Activate AI kurucu ortağı Pratyush Choudhury ise büyük teknoloji laboratuvarlarının her dil için benzer görevlerin maliyetini gösteren bir karne yayımlamasını önerdi.
Ekonomik ve Stratejik Değerlendirme
Yapay zekâ mimarilerindeki token farkları, Türkçe veri işleyen şirketler ve yazılım geliştiriciler için doğrudan operasyonel bir maliyet dezavantajı doğuruyor. OpenAI'de yüzde 31, DeepSeek'te yüzde 83'e varan oranlar, aynı içerik hacminin API üzerinden işlenmesinde Türkçe projelerin İngilizceye kıyasla daha yüksek bütçeler harcamasına ve bağlam sınırlarını daha erken tüketmesine yol açıyor.
Türkiye'de araştırmacıların yerel dil yapısına uygun token araçları geliştirmesine rağmen, küresel modellerin hızlı güncelleme döngüleri yerel çözümlerin rekabet gücünü zorluyor. Teknolojideki bu dilsel ayrışmanın giderilmesi, hem küresel geliştiricilerin veri setlerini çeşitlendirmesine hem de Türkçe odaklı yapay zekâ altyapı yatırımlarının sürdürülebilirliğine bağlı görünüyor.
💬 Yorumlar 0
✍️ Bir Yorum Bırakın